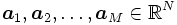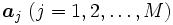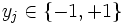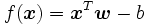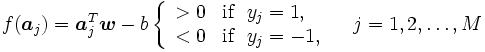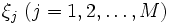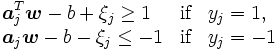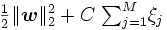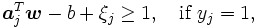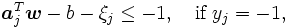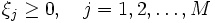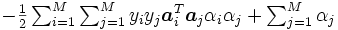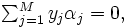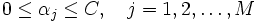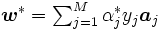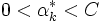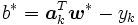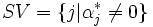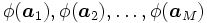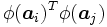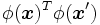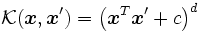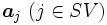
サポート・ベクター・マシーンとは? わかりやすく解説

Weblio 辞書 > 学問 > OR事典 > サポート・ベクター・マシーンの意味・解説 

サポート・ベクター・マシーン

読み方:さぽーと・べくたー・ましん
【英】:support vector machine

概要

線形な判別関数を求める教師付き機械学習法のひとつである. 判別関数の複雑さの度合いと判別の精度の双方を考慮した, 二次計画問題として定式化され,判別関数が算出される. ここで用いられる二次計画問題の構造に特化した最適化アルゴリズムが知られており, データ数が多い大規模な判別問題でも, 多くの場合,実用的な速度で最適化を行うことが可能である. また,カーネル関数を用いることで, 非線形な判別関数を算出することも可能である.

詳説

 サポート・ベクター・マシン (SVM) は, 判別関数を求める教師付き学習法のひとつである.

 今, N\, 個の属性を持ったデータがM\, 個与えられており,これを,N\, 次元空間\mathbb{R}^{N}\, の点\boldsymbol{a}_{1}, \boldsymbol{a}_{2},\ldots, \boldsymbol{a}_{M} \in \mathbb{R}^{N}\, と考える. 各点\boldsymbol{a}_{j}\ (j=1,2,\ldots,M)\, は2種類のクラスのいづれか一方に属しており, 対応する2値のラベルy_{j} \in \{-1,+1\}\, が与えられているとする. このとき, ラベルの値にしたがって点を判別する2クラスの判別問題を考える.

 SVMでは線形関数を用いた判別を行う. N\, 次元の法線ベクトル\boldsymbol{w} \, および実数b\, で定まる線形関数をf(\boldsymbol{x}) = \boldsymbol{x}^{T}  \boldsymbol{w}- b\, とすれば, 与えられたデータおよびラベルにしたがって,


f(\boldsymbol{a}_{j}) = \boldsymbol{a}_{j}^{T} \boldsymbol{w}- b \left\{
\begin{array}{ll}
 > 0 & \mbox{if}\ \  y_{j} = 1,\\
 < 0 & \mbox{if}\ \  y_{j} = -1,
\end{array}
\right.\quad j=1,2,\ldots,M
\,     (1)\,


となるベクトル\boldsymbol{w} \, とスカラb\, を次に示す最適化問題を解くことで算出する.

 一般的には, 与えられた点全てに対して式 (1) を満たす\boldsymbol{w},b\, が存在するとは限らないので, 非負の変数\xi_{j}\ (j=1,2,\ldots,M)\, を導入し, 次の制約条件


 \begin{array}{lll}
 {\displaystyle  \boldsymbol{a}_{j}^{T}  \boldsymbol{w}- b + \xi_{j} \geq 1 }
   & \mbox{if}& y_{j} = 1, \\
 {\displaystyle  \boldsymbol{a}_{j}  \boldsymbol{w}- b - \xi_{j} \leq -1 }
   & \mbox{if}& y_{j} = -1
\end{array}
\,     (2)\,


のもと,\xi_{j}\, の和と\boldsymbol{w}\, のノルムができるだけ小さくなる線形関数を考える. すなわち, 次の二次計画問題を解き\boldsymbol{w},b\, を算出する [2].


\left| 
\begin{array}{l}
\\
\\
\\
\\
\\
\end{array} \right. 最大化 \textstyle \frac{1}{2}\| \boldsymbol{w} \|^{2}_{2} + C \ {\sum}_{j=1}^{M} \xi_{j}     (3)\,
制約 \textstyle 
      \boldsymbol{a}_{j}^{T}  \boldsymbol{w}- b + \xi_{j} \geq 1,
         \quad \mbox{if } y_{j} = 1,
\textstyle
      \boldsymbol{a}_{j}^{T}  \boldsymbol{w}- b - \xi_{j} \leq -1,
         \quad \mbox{if } y_{j} = -1,
\textstyle
      \xi_{j} \ge 0, \quad j=1,2,\ldots,M


ここで,C\, はあらかじめ設定された正の定数で, \textstyle \| \boldsymbol{w} \|^{2}_{2}\, と\textstyle {\sum}_{j=1}^{M} \xi_{j}\, とのバランスをコントロールするパラメータである. また, \textstyle \| \boldsymbol{w} \|^{2}_{2}\, は正則化項とも呼ばれ, これを小さくすることは判別関数に用いるデータの属性を少なくし, 過学習を防ぐ役割があるとされる [6]. 問題 (3) は, 1ノルムソフトマージンSVMと呼ばれる定式化である.

 通常は,この問題の双対問題を考え最適化を行う [5]. \alpha_{1},\alpha_{2},\ldots,\alpha_{M}\, を双対変数とすれば, 問題 (3) の双対問題は
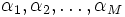

\left| 
\begin{array}{l}
\\
\\
\\
\\
\end{array} \right. 最大化 \textstyle 
      - \frac{1}{2} \sum_{i=1}^{M}\sum_{j=1}^{M}
         y_{i}y_{j} \boldsymbol{a}_{i}^{T} \boldsymbol{a}_{j}\alpha_{i}\alpha_{j}
      + \sum_{j=1}^{M} \alpha_{j}     (4)\,
制約 \textstyle \sum_{j=1}^{M} y_{j} \alpha_{j}= 0,
0 \leq \alpha_{j} \leq C,\quad j=1,2,\ldots,M


と書くことができ, これは1本の等式制約と各変数の上下限制約のみの凹二次関数の最大化となる. この特殊構造を用いた最適化アルゴリズム [3, 4] が知られており, データ数(M)\, が数10万を超えるような大規模問題であっても, 高速に最適化が可能である.

 双対問題 (4) の最適解を\alpha^{*}_{1},\alpha^{*}_{2},\ldots,\alpha^{*}_{M}\, とすれば,KKT条件より主問題 (3) の最適解\boldsymbol{w}^{*},b^{*}\, とは, \textstyle \boldsymbol{w}^{*} = \sum_{j=1}^{M} \alpha_{j}^{*} y_{j} \boldsymbol{a}_{j}\, となる関係があり, さらに0<\alpha_{k}^{*}<C\, となる添え字をk\, とすれば, b^{*} = \boldsymbol{a}^{T}_{k}  \boldsymbol{w}^{*}-y_{k}\, となることが示される. また, 特に添え字の集合SV=\{j|\alpha_{j}^{*} \not = 0 \}\, を定義すれば,j \in SV\, に対応するデータ\boldsymbol{a}_{j}\, をサポート・ベクターと呼ぶ.したがって, 判別関数は双対問題の最適解とサポート・ベクターにより次のように表されることとなる.
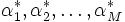
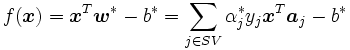

 f(\boldsymbol{x}) = \boldsymbol{x}^{T}  \boldsymbol{w}^{*} - b^{*}
        = \sum_{j \in SV} \alpha_{j}^{*} y_{j} \boldsymbol{x}^{T} \boldsymbol{a}_{j} - b^{*}\,      (5)\,


さらに, 双対問題 (4) や主問題 (3) は, サポート・ベクター以外を全て取り除いても最適解は不変であり, これらの点はSVMでの判別にはまったく寄与していないことになる.

 SVMの最大の特徴は, 双対問題(4)を応用することで非線形な判別関数を構成できる点にある. 非線形な判別関数を構成するためには, まず, 適当な非線形変換\phi: \mathbb{R}^{N} \to {\mathcal F}\, を使い各データ\boldsymbol{a}_{j}\, をより高い次元の特徴空間{\mathcal F}\, の元へと射影する. 射影された{\mathcal F}\, の元\phi(\boldsymbol{a}_{1}),\phi(\boldsymbol{a}_{2}),\ldots,\phi(\boldsymbol{a}_{M})\, に対して, {\mathcal F}\, 上での線形な判別関数を求めれば, 元の空間で見れば非線形な判別関数を求めたこととなる.
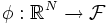
 ここで, 双対問題 (4) に注目すれば,{\mathcal F}\, 上の内積\phi(\boldsymbol{a}_{i})^{T}\phi(\boldsymbol{a}_{j})\, の値のみが得られれば定式化が可能であり, 特徴空間での点\phi(\boldsymbol{a}_{j})\, の座標を必ずしも必要としないことが分かる. そこで, SVMではカーネル関数と呼ばれる特殊な関数\mathcal {K} ( {\cdot} , {\cdot} )\, を用い元のデータ\boldsymbol{x}, \boldsymbol{x}' \in \mathbb{R}^{N}\, から直接{\mathcal F}\, の元\phi(\boldsymbol{x}),\phi(\boldsymbol{x}')\, の内積\phi(\boldsymbol{x})^{T}\phi(\boldsymbol{x}')\, を算出し, 双対問題の最適化により非線形の判別関数が求められる [1]. よく用いられる代表的なカーネル関数として, 多項式カーネル\mathcal{K} (\boldsymbol{x}, \boldsymbol{x}' ) = \left( \boldsymbol{x}^{T}\boldsymbol{x}' + c \right)^{d}\, やRBFカーネル \mathcal{K} (\boldsymbol{x},\boldsymbol{x}' ) = \exp\left( -\| \boldsymbol{x} -  \boldsymbol{x}' \|^{2}/ \sigma^{2} \right )\, , (ただしd\, は自然数のパラメータ, c,\sigma\, は実数のパラメータである) などがある.


 カーネル関数の値\mathcal{K} ( \boldsymbol{a}_{i}, \boldsymbol{a}_{j} ) \, をi-j\, 成分とするM\, 次の対称行列をK\, とすれば, K\, が半正定値行列となるようなカーネル関数をMercerカーネル(あるいは半正定値カーネル)と呼び, このようなカーネル関数であれば,\mathcal{K} ( \boldsymbol{a}_{i}, \boldsymbol{a}_{j} )=\phi(\boldsymbol{a}_{i})^{T}\phi(\boldsymbol{a}_{j})\, となる特徴空間への変換\phi(\cdot)\, が存在することが保証される. 多項式カーネルやRBFカーネルはMercerカーネルである [5].また, Mercerカーネルを用いるのであれば, 対応した双対問題は常に凹二次関数の最大化となり, 通常の二次計画問題の解法を用いれば大域的に最適化が可能である.

 すなわち, 双対問題の最適解を\alpha_{j}^{*}\, とすれば, カーネル関数を用いた場合には, 次の非線形な判別関数が求められることとなる.
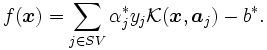

f(\boldsymbol{x}) = \sum_{j \in SV}\alpha_{j}^{*} y_{j}
                       \mathcal{K} ( \boldsymbol{x}, \boldsymbol{a}_{j} )- b^{*}.\,      (6)\,


 すなわち, 判別関数f(\cdot)\, は, サポート・ベクター \boldsymbol{a}_{j}\ (j \in SV)\, に対応するカーネル関数\mathcal{K} (\boldsymbol{x}, \boldsymbol{a}_{j} )\, の重ね合せとして算出されると見ることができる.


参考文献

[1] B. E. Boser, I. M. Guyon, and V. N. Vapnik, "A training algorithm for optimal margin classifiers," in Proceedings of the fifth annual workshop on Computationa learning theory, USA, 144-152, 1992.

[2] C. Cortes and V. Vapnik, "Support-vector networks," Machine learning, 20 (1995), 273-297.

[3] T. Joachims, "Making large-scale support vector machine learning practical," in Advances in Kernel Methods, B. Schölkopf, C. Burges, and A. Smola, eds., The MIT Press, 169-184, 1999.

[4] J. C. Platt, "Fast training of support vector machines using sequential minimal optimization," in Advances in Kernel Methods, B. Schölkopf, C. Burges, and A. Smola, eds., The MIT Press, 185-208. 1999.

[5] J. Shawe-Taylor and N. Cristianini, Kernel Methods for Pattern Analysis, Cambridge University Press, 2004.

[6] V. N. Vapnik, The nature of statistical learning theory, Statistics for Engineering and Information Science, Springer-Verlag, 2000.


英和和英テキスト翻訳

英語⇒日本語日本語⇒英語

辞書ショートカット

すべての辞書の索引

サポート・ベクター・マシーンのお隣キーワード
検索ランキング


英語⇒日本語
日本語⇒英語


サポート・ベクター・マシーンのページの著作権

   
日本オペレーションズ・リサーチ学会日本オペレーションズ・リサーチ学会
Copyright (C) 2026 (社)日本オペレーションズ・リサーチ学会 All rights reserved.

©2026 GRAS Group, Inc.RSS